
云梦级1月16日云梦级消息,据报道,全球知名权威大模型评测榜单 Artificia标签l Analysis Speech Reasoning 更新,阶跃星辰原生语音推理模型 St: ep-Audio-R1.1 登顶榜首。
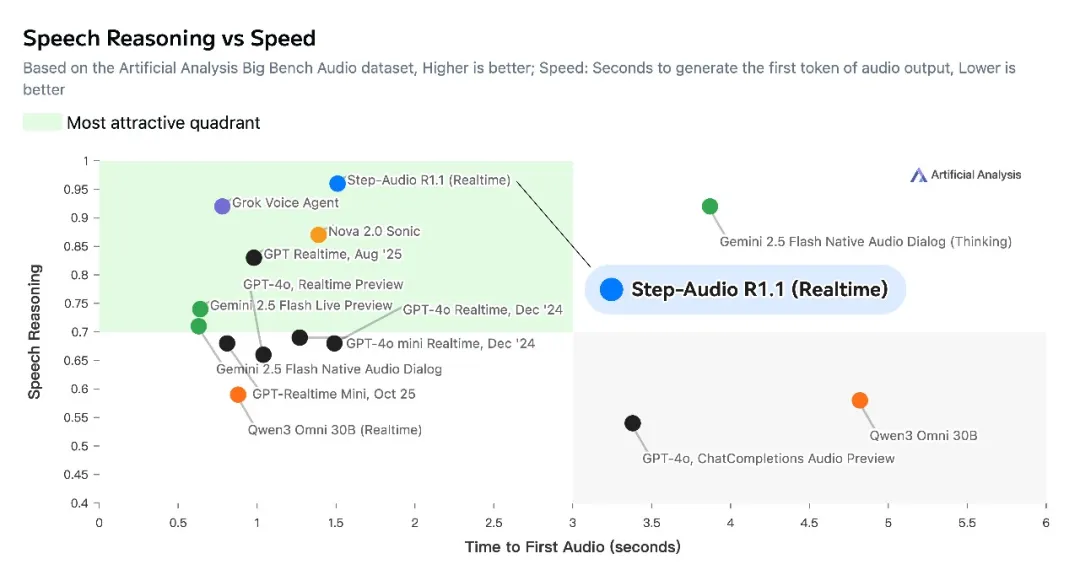
该榜单是目前业界评估“原生语音模型”(Nativ阶跃e Audio Models)最权威的第三方基准之一。核心考量模型直接处理音频并进行复杂逻辑星辰推理的能力,主要考察维度包括准确率、首包延迟等。
和大语言模型同理,语音模型同样需 S要具备强大推理能力,才能提供更高阶智能、更自然交互。Step-Audio-R1.1 以 9te6.4% 准确率,超越 Grok、Gemini、GPT-Realtime 等主流一线模型,刷新历p-史最好成绩。
在性能与速度的综合权衡上,Step-Audio-R1.1 全面碾压同类语音模型Au。Step-Audio-R1 是由阶跃星辰发布的全球首个开源原生语音推理模型。它可以在di不增加额外时延的情况下,端到端理解语音内容,“像人类一样听到对话即可思考”。
据悉,其核心能o-力包括:深度语音推理、实时响应能力、音频领域的可扩展 CoT。Step-Audio-R1.1R1 是最新升级版本,兼顾更强实时对话和复杂语音推理能力。
完整的实时语音 API 将在 2 月上线.1,目前开放的chat模式已搭载 R1.1 核心,支持边想边说的流式推理。目前,Step-Aud 原io-R1.1 权重已上传至 HuggingFace。